Skip to content
Back Propagation

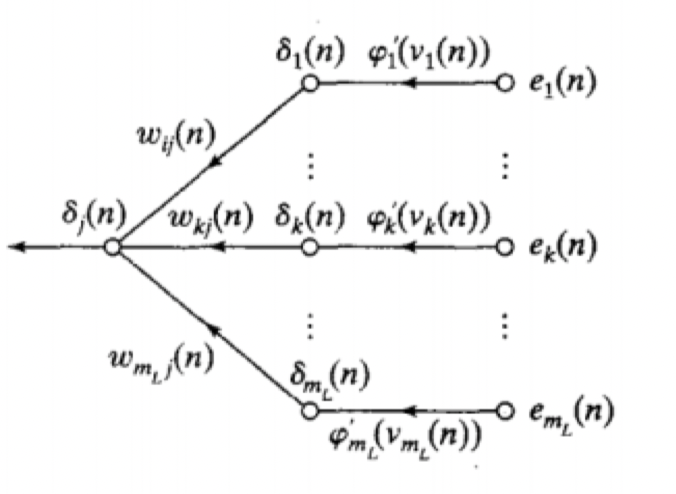
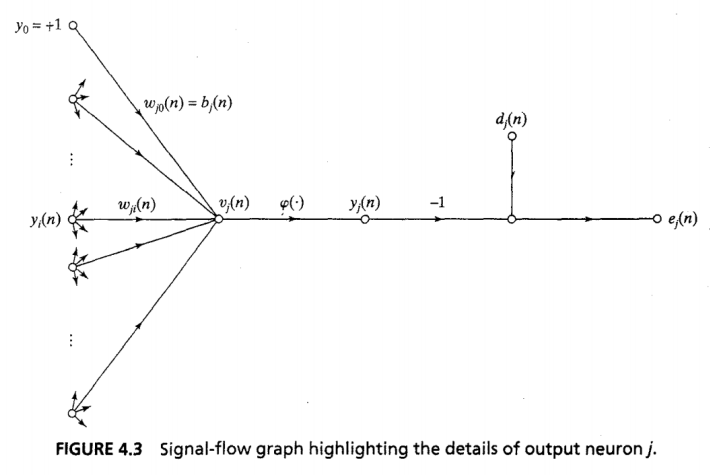
Error signal graph

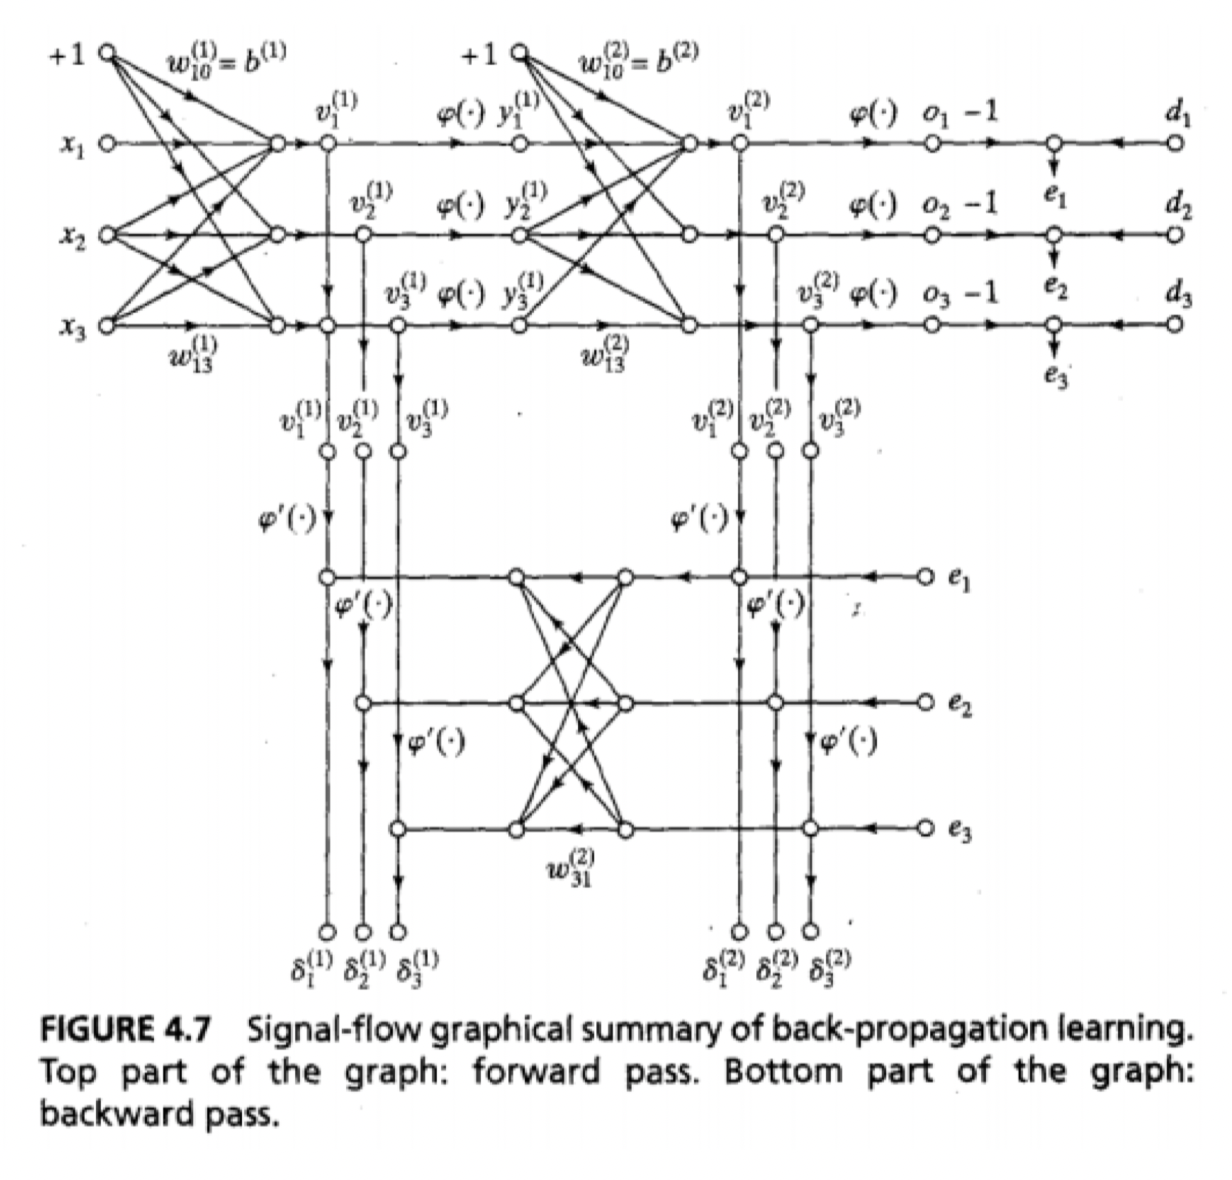
mlp-arch-graph

  1. Error Signal
    • ej(n)=dj(n)−yj(n)e_j(n)=d_j(n)-y_j(n)
  2. Net Internal Sum
    • vj(n)=∑i=0mwji(n)yi(n)v_j(n)=\sum_{i=0}^mw_{ji}(n)y_i(n)
  3. Output
    • yj(n)=φj(vj(n))y_j(n)=\varphi_j(v_j(n))
  4. Instantaneous Sum of Squared Errors
    • E(n)=12∑j∈Cej2(n)\mathfrak{E}(n)=\frac 1 2 \sum_{j\in C}e_j^2(n)
    • CC = o/p layer nodes
  5. Average Squared Error
    • Eav=1N∑n=1NE(n)\mathfrak E_{av}=\frac 1 N\sum_{n=1}^N\mathfrak E (n)
∂E(n)∂wji(n)=∂E(n)∂ej(n)∂ej(n)∂yj(n)∂yj(n)∂vj(n)∂vj(n)∂wji(n)\frac{\partial\mathfrak E(n)}{\partial w_{ji}(n)}= \frac{\partial\mathfrak E(n)}{\partial e_j(n)} \frac{\partial e_j(n)}{\partial y_j(n)} \frac{\partial y_j(n)}{\partial v_j(n)} \frac{\partial v_j(n)}{\partial w_{ji}(n)}

From 4

∂E(n)∂ej(n)=ej(n)\frac{\partial\mathfrak E(n)}{\partial e_j(n)}=e_j(n)

From 1

∂ej(n)∂yj(n)=−1\frac{\partial e_j(n)}{\partial y_j(n)}=-1

From 3 (note prime)

∂yj(n)∂vj(n)=φj′(vj(n))\frac{\partial y_j(n)}{\partial v_j(n)}=\varphi_j'(v_j(n))

From 2

∂vj(n)∂wji(n)=yi(n)\frac{\partial v_j(n)}{\partial w_{ji}(n)}=y_i(n)

Composite

∂E(n)∂wji(n)=−ej(n)⋅φj′(vj(n))⋅yi(n)\frac{\partial\mathfrak E(n)}{\partial w_{ji}(n)}= -e_j(n)\cdot \varphi_j'(v_j(n))\cdot y_i(n) Δwji(n)=−η∂E(n)∂wji(n)\Delta w_{ji}(n)=-\eta\frac{\partial\mathfrak E(n)}{\partial w_{ji}(n)}

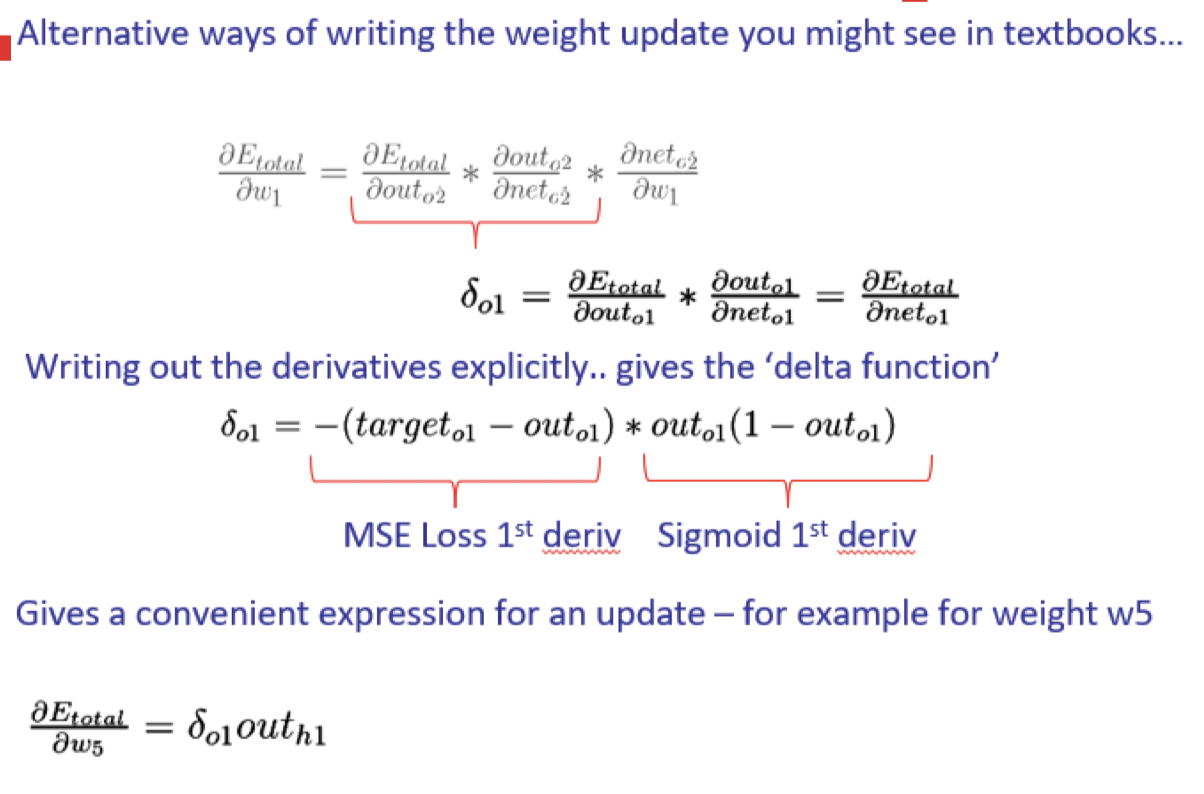
Δwji(n)=ηδj(n)yi(n)\Delta w_{ji}(n)=\eta\delta_j(n)y_i(n)

Gradients

Output Local

δj(n)=−∂E(n)∂vj(n)\delta_j(n)=-\frac{\partial\mathfrak E (n)}{\partial v_j(n)}

=−∂E(n)∂ej(n)∂ej(n)∂yj(n)∂yj(n)∂vj(n)=- \frac{\partial\mathfrak E(n)}{\partial e_j(n)} \frac{\partial e_j(n)}{\partial y_j(n)} \frac{\partial y_j(n)}{\partial v_j(n)}

=ej(n)⋅φj′(vj(n))= e_j(n)\cdot \varphi_j'(v_j(n))

Hidden Local

δj(n)=−∂E(n)∂yj(n)∂yj(n)∂vj(n)\delta_j(n)=- \frac{\partial\mathfrak E (n)}{\partial y_j(n)} \frac{\partial y_j(n)}{\partial v_j(n)}

=−∂E(n)∂yj(n)⋅φj′(vj(n))=- \frac{\partial\mathfrak E (n)}{\partial y_j(n)} \cdot \varphi_j'(v_j(n))

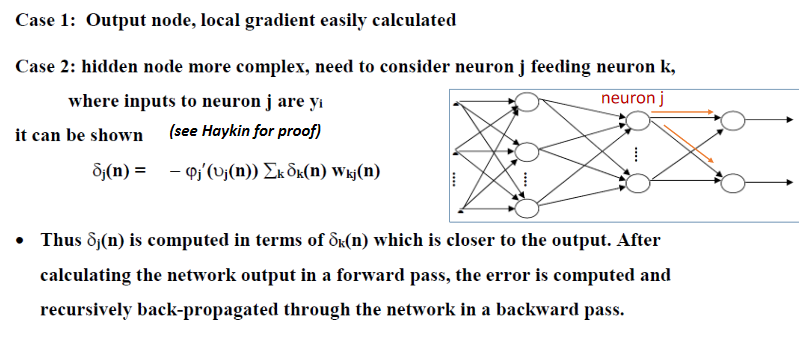
δj(n)=φj′(vj(n))⋅∑kδk(n)⋅wkj(n)\delta_j(n)= \varphi_j'(v_j(n)) \cdot \sum_k \delta_k(n)\cdot w_{kj}(n)

Weight Correction

weight correction = learning rate ⋅ local gradient ⋅ input signal of neuron j\text{weight correction = learning rate $\cdot$ local gradient $\cdot$ input signal of neuron $j$}

Δwji(n)=η⋅δj(n)⋅yi(n)\Delta w_{ji}(n)=\eta\cdot\delta_j(n)\cdot y_i(n)
  • Looking for partial derivative of error with respect to each weight
  • 4 partial derivatives
    1. Sum of squared errors WRT error in one output node
    2. Error WRT output yy
    3. Output yy WRT Pre-activation function sum
    4. Pre-activation function sum WRT weight
      • Other weights constant, goes to zero
      • Leaves just yiy_i
    • Collect 3 boxed terms as delta jj
      • Local gradient
  • Weight correction can be too slow raw
    • Gets stuck
    • Add momentum

mlp-local-hidden-grad

  • Nodes further back
    • More complicated
    • Sum of later local gradients multiplied by backward weight (orange)
    • Multiplied by differential of activation function at node

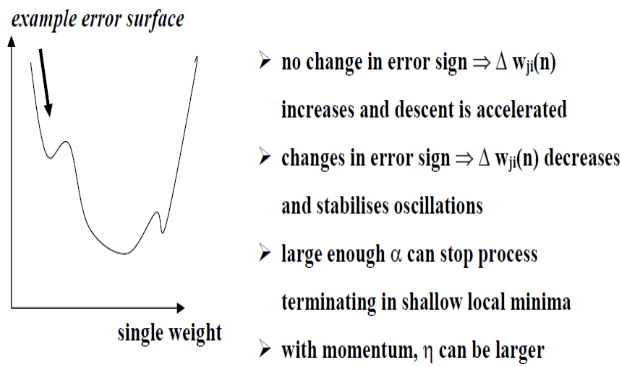
Global Minimum

  • Much more complex error surface than least-means-squared
  • No guarantees of convergence
    • Non-linear optimisation
  • Momentum
    • +αΔwji(n−1),0≤∣α∣<1+\alpha\Delta w_{ji}(n-1), 0\leq|\alpha|<1
    • Proportional to the change in weights last iteration
      • Can shoot past local minima if descending quickly
mlp-global-minimum

back-prop1 back-prop2

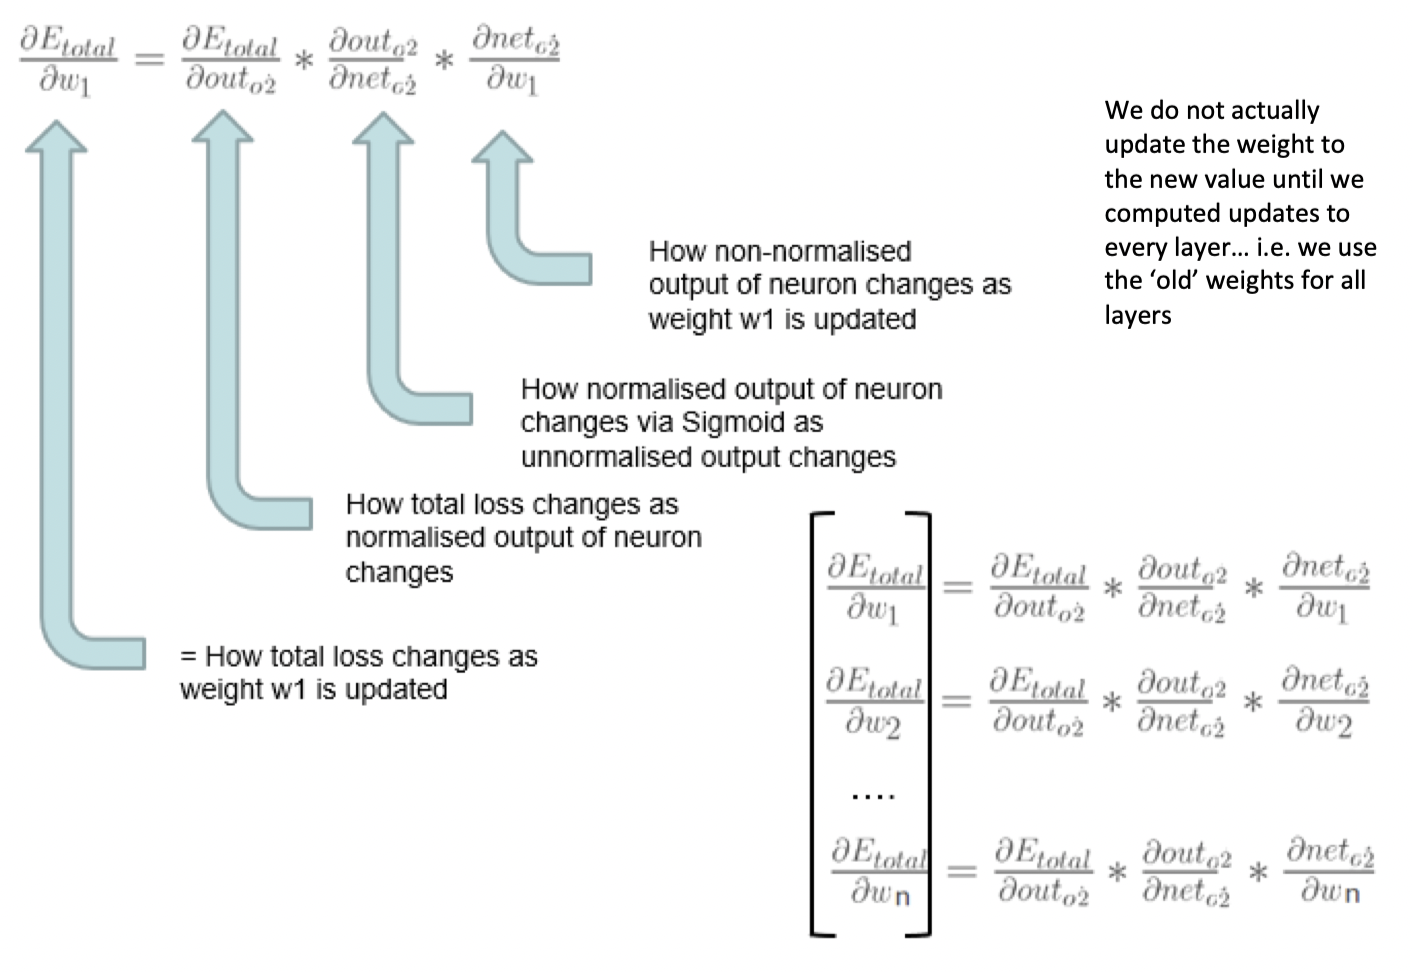
back-prop-equations

w5+=w5−η⋅∂Etotal∂w5w^+_5=w_5-\eta\cdot\frac{\partial E_{total}}{\partial w_5}

back-prop-weight-changes